BenchForge : comparer les modèles IA sans dogme
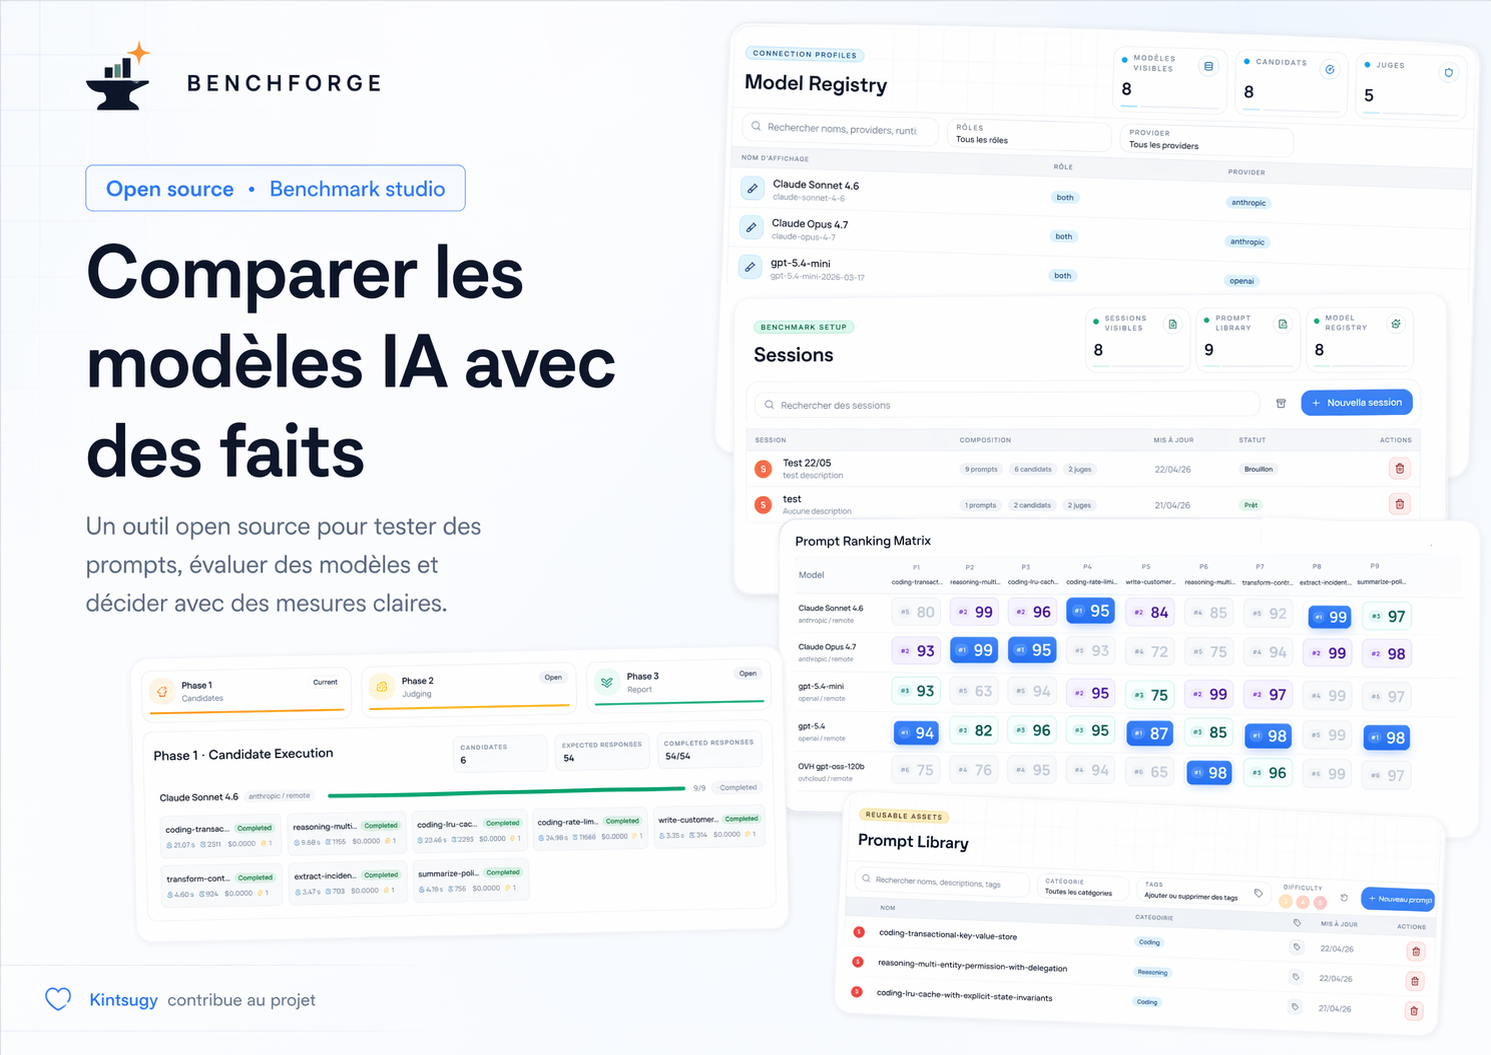
BenchForge est un outil open source auquel Kintsugy participe pour comparer des modèles IA sur des cas d’usage réels. L’objectif : tester les prompts, mesurer les coûts, analyser la qualité des réponses et décider avec des faits plutôt qu’avec des impressions.
Comparer les modèles IA sans dogme : pourquoi Kintsugy contribue à BenchForge
L’écosystème IA avance à une vitesse difficile à suivre. Chaque semaine, de nouveaux modèles apparaissent, les benchmarks publics évoluent, les coûts changent, et les architectures locales deviennent de plus en plus crédibles.
Pourtant, dans beaucoup d’équipes, une question revient sans cesse : quel modèle utiliser, pour quel cas d’usage, et à quel coût réel ?
Le débat oppose souvent deux réflexes. D’un côté, utiliser le plus gros modèle disponible “par sécurité”. De l’autre, basculer vers du local ou de l’open source pour reprendre le contrôle. Dans les deux cas, le risque est le même : décider sur impression plutôt que sur mesure.
Le vrai sujet n’est pas seulement la performance
On parle souvent des modèles IA en termes de capacité brute : raisonnement, taille de contexte, vitesse, qualité de génération, coût par token. Ces métriques sont utiles, mais elles ne suffisent pas.
Dans un contexte projet, un modèle doit être évalué sur des cas concrets : classification, extraction, résumé, raisonnement métier, reformulation, génération structurée, analyse de documents ou assistance à la décision.
Point critique
Un modèle excellent sur un benchmark généraliste peut être moyen sur un cas métier précis. À l’inverse, un modèle plus petit peut être largement suffisant si le besoin est bien cadré.
La bonne question n’est donc pas :
Quel est le meilleur modèle ?
Mais plutôt :
Quel est le meilleur compromis pour mon usage, mes contraintes et mon budget ?
BenchForge : tester au lieu de supposer
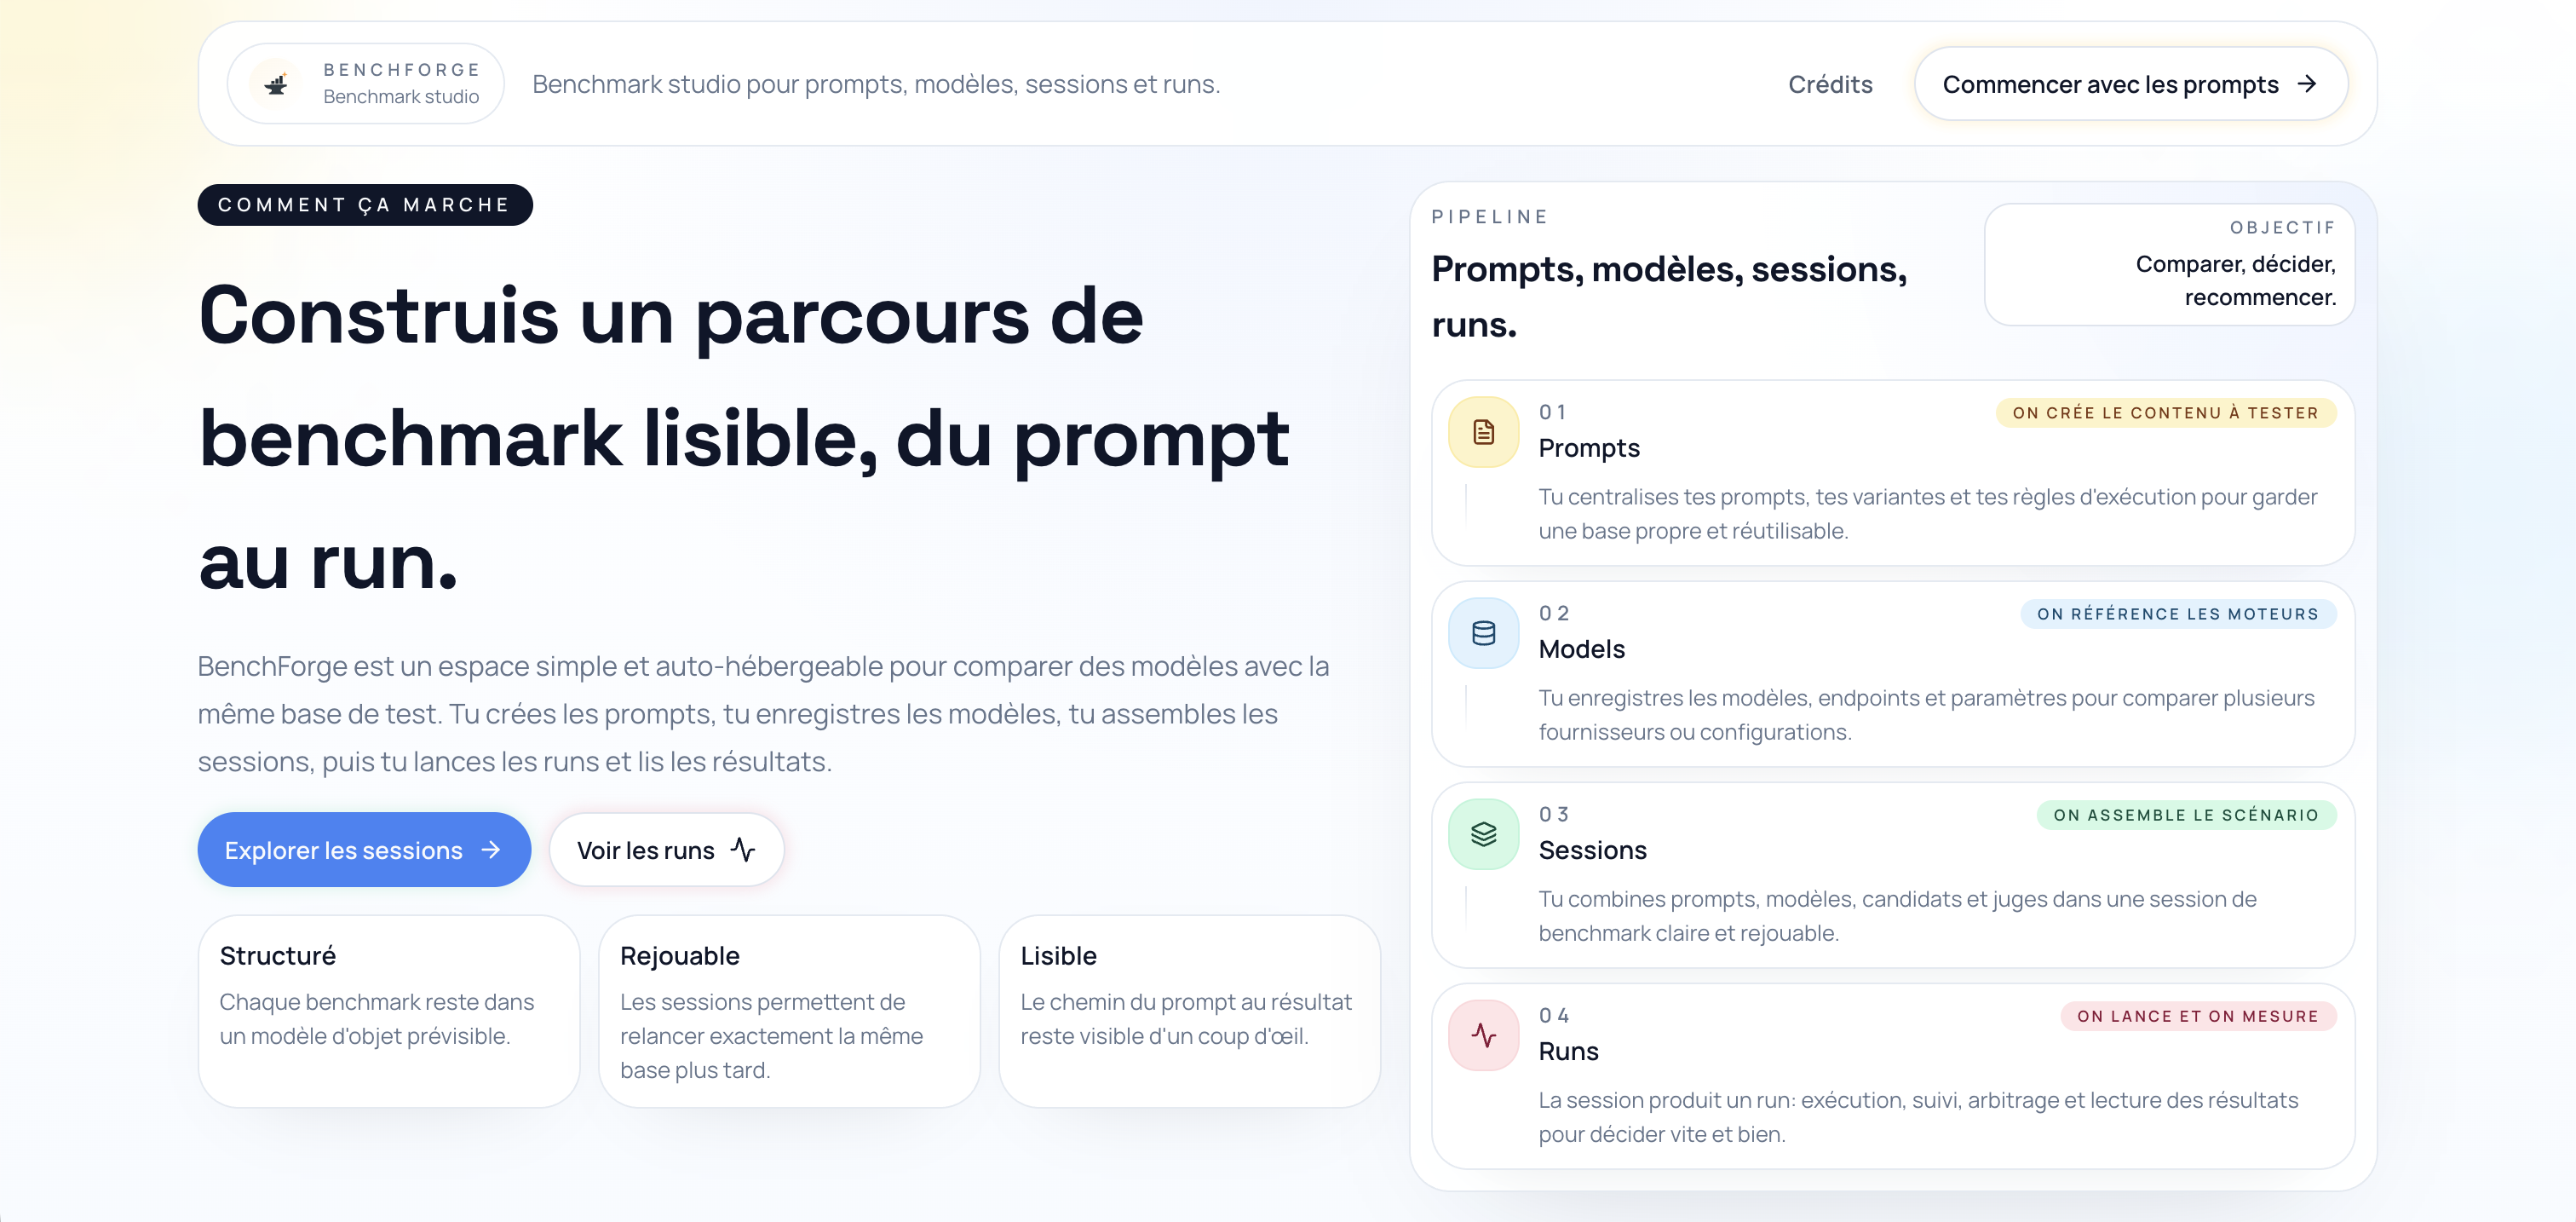
BenchForge permet de comparer plusieurs modèles sur une même base de prompts. L’objectif est simple : exécuter les mêmes tests, sur les mêmes entrées, avec des critères d’évaluation identiques, puis produire une lecture claire des résultats.
BenchForge est un projet open source auquel Kintsugy participe. Il est né d’un besoin très concret : sortir des discussions théoriques sur les modèles IA et construire une base de comparaison reproductible.
L’outil permet de gérer une bibliothèque de prompts, d’enregistrer différents modèles candidats, de lancer des sessions de benchmark, puis de consolider les résultats dans des rapports exploitables.
À retenir
BenchForge ne cherche pas à désigner un modèle universellement meilleur. Il aide à identifier le modèle le plus pertinent pour un contexte donné.
Pourquoi cette comparaison devient indispensable
Les choix de modèles ont désormais un impact direct sur les coûts, la performance produit, la confidentialité, l’infrastructure et l’expérience utilisateur.
Utiliser un modèle très puissant pour chaque requête peut sembler confortable. Mais si 80 % des tâches peuvent être traitées par un modèle plus petit, moins cher ou hébergé localement, le coût d’opportunité devient important.
À l’inverse, basculer trop vite vers un modèle open source local sans mesure sérieuse peut créer d’autres problèmes : qualité instable, latence, complexité d’hébergement ou difficulté à maintenir les performances dans le temps.
Bonne pratique
Avant de choisir un modèle, construisez un jeu de prompts représentatif de vos vrais usages. Les tests doivent refléter votre production, pas uniquement des exemples génériques.
BenchForge apporte un cadre simple pour objectiver ces choix. On ne compare pas seulement des noms de modèles. On compare des réponses, des coûts, des temps de latence, des scores et des comportements sur des tâches précises.
Première brique : une bibliothèque de prompts maîtrisée
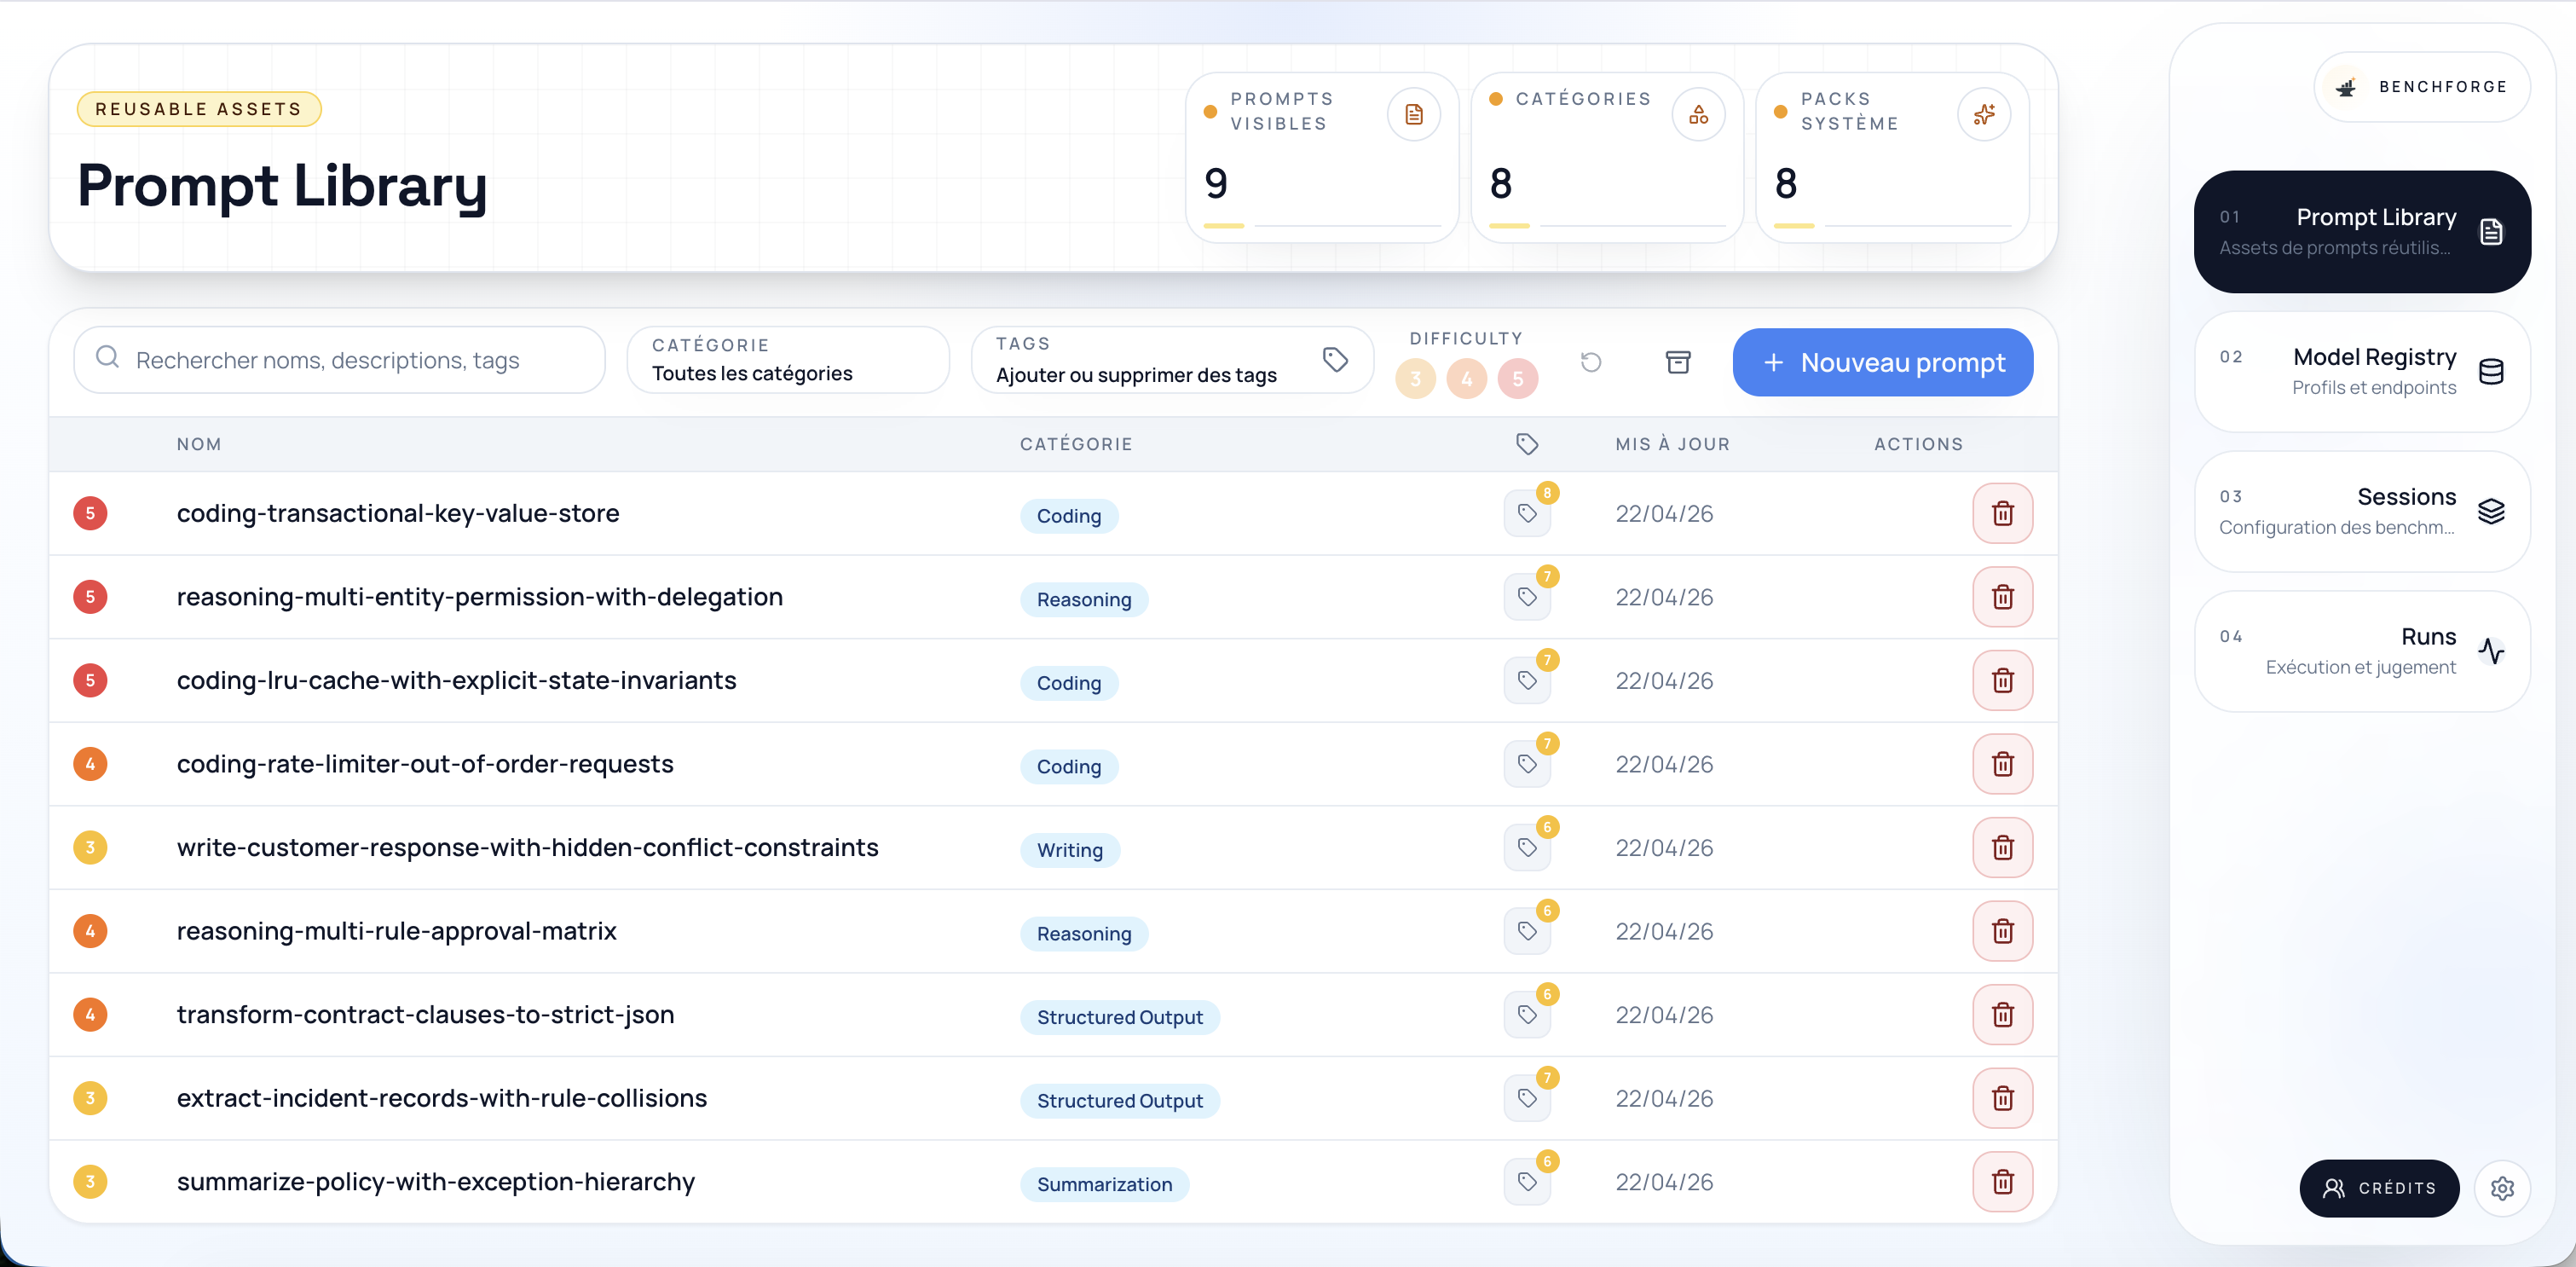
La Prompt Library centralise les prompts à tester, leurs catégories, leurs tags et leur statut. Elle permet de construire progressivement une base de tests stable, maintenable et réutilisable.
Dans beaucoup de projets IA, les prompts vivent dans des fichiers dispersés, des tickets, des notebooks ou directement dans le code. Cela fonctionne au début, puis devient vite difficile à maintenir.
BenchForge introduit une logique plus propre : les prompts deviennent des éléments de test à part entière. Ils peuvent être catégorisés, filtrés, tagués et rejoués dans différentes sessions.
Cette approche change la manière de travailler. On ne teste plus “un modèle” de façon vague. On teste un modèle sur une collection de cas d’usage explicites.
À partir du moment où un prompt sert à prendre une décision ou à produire une sortie métier, il mérite d’être suivi avec la même rigueur qu’un composant logiciel.
Deuxième brique : un registre de modèles comparable
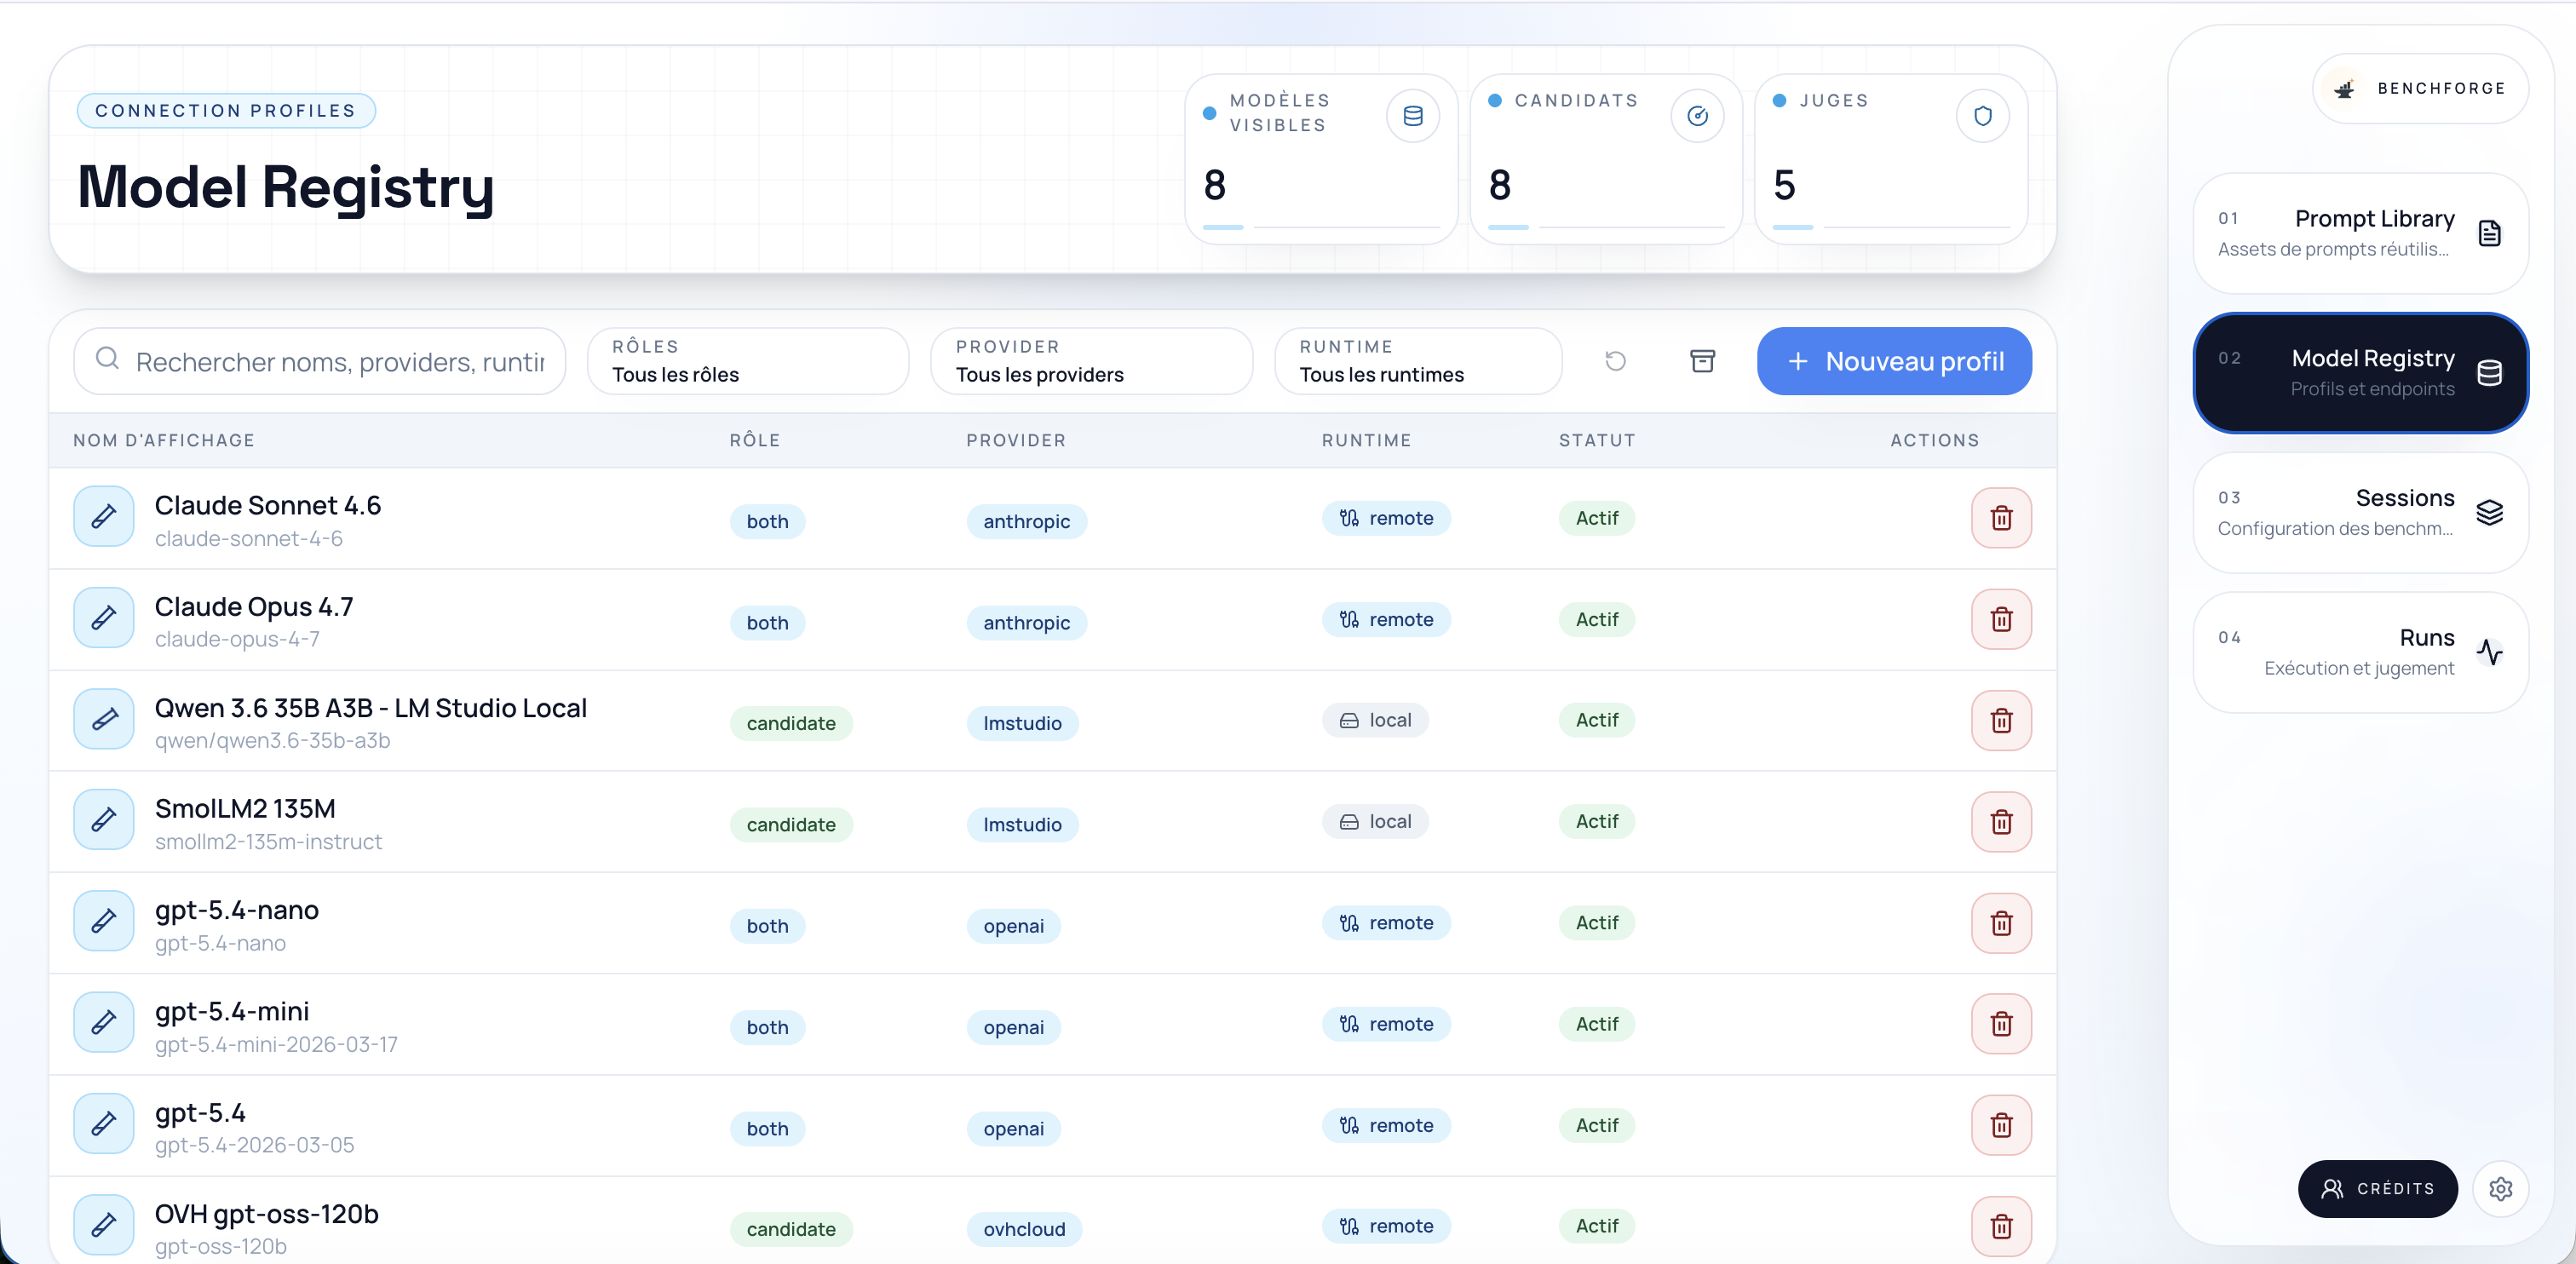
Le Model Registry permet de déclarer les modèles à comparer : modèles propriétaires, modèles open source, modèles locaux, variantes quantifiées ou endpoints spécifiques.
Le choix d’un modèle n’est plus binaire. Entre les grands modèles propriétaires, les modèles open source hébergés, les modèles locaux, les variantes quantifiées et les endpoints spécialisés, les combinaisons deviennent nombreuses.
C’est précisément là que le registre de modèles devient utile. Il permet de poser une base claire : quels modèles sont testés, avec quel fournisseur, quel runtime, quel statut et quelles contraintes.
Cette transparence est importante, car deux modèles portant presque le même nom peuvent avoir des comportements différents selon leur version, leur quantification, leur endpoint ou leur configuration d’inférence.
Attention
Comparer des modèles sans tracer leur version, leur fournisseur et leur configuration revient à produire un benchmark difficilement exploitable.
Troisième brique : des sessions pour rejouer les tests
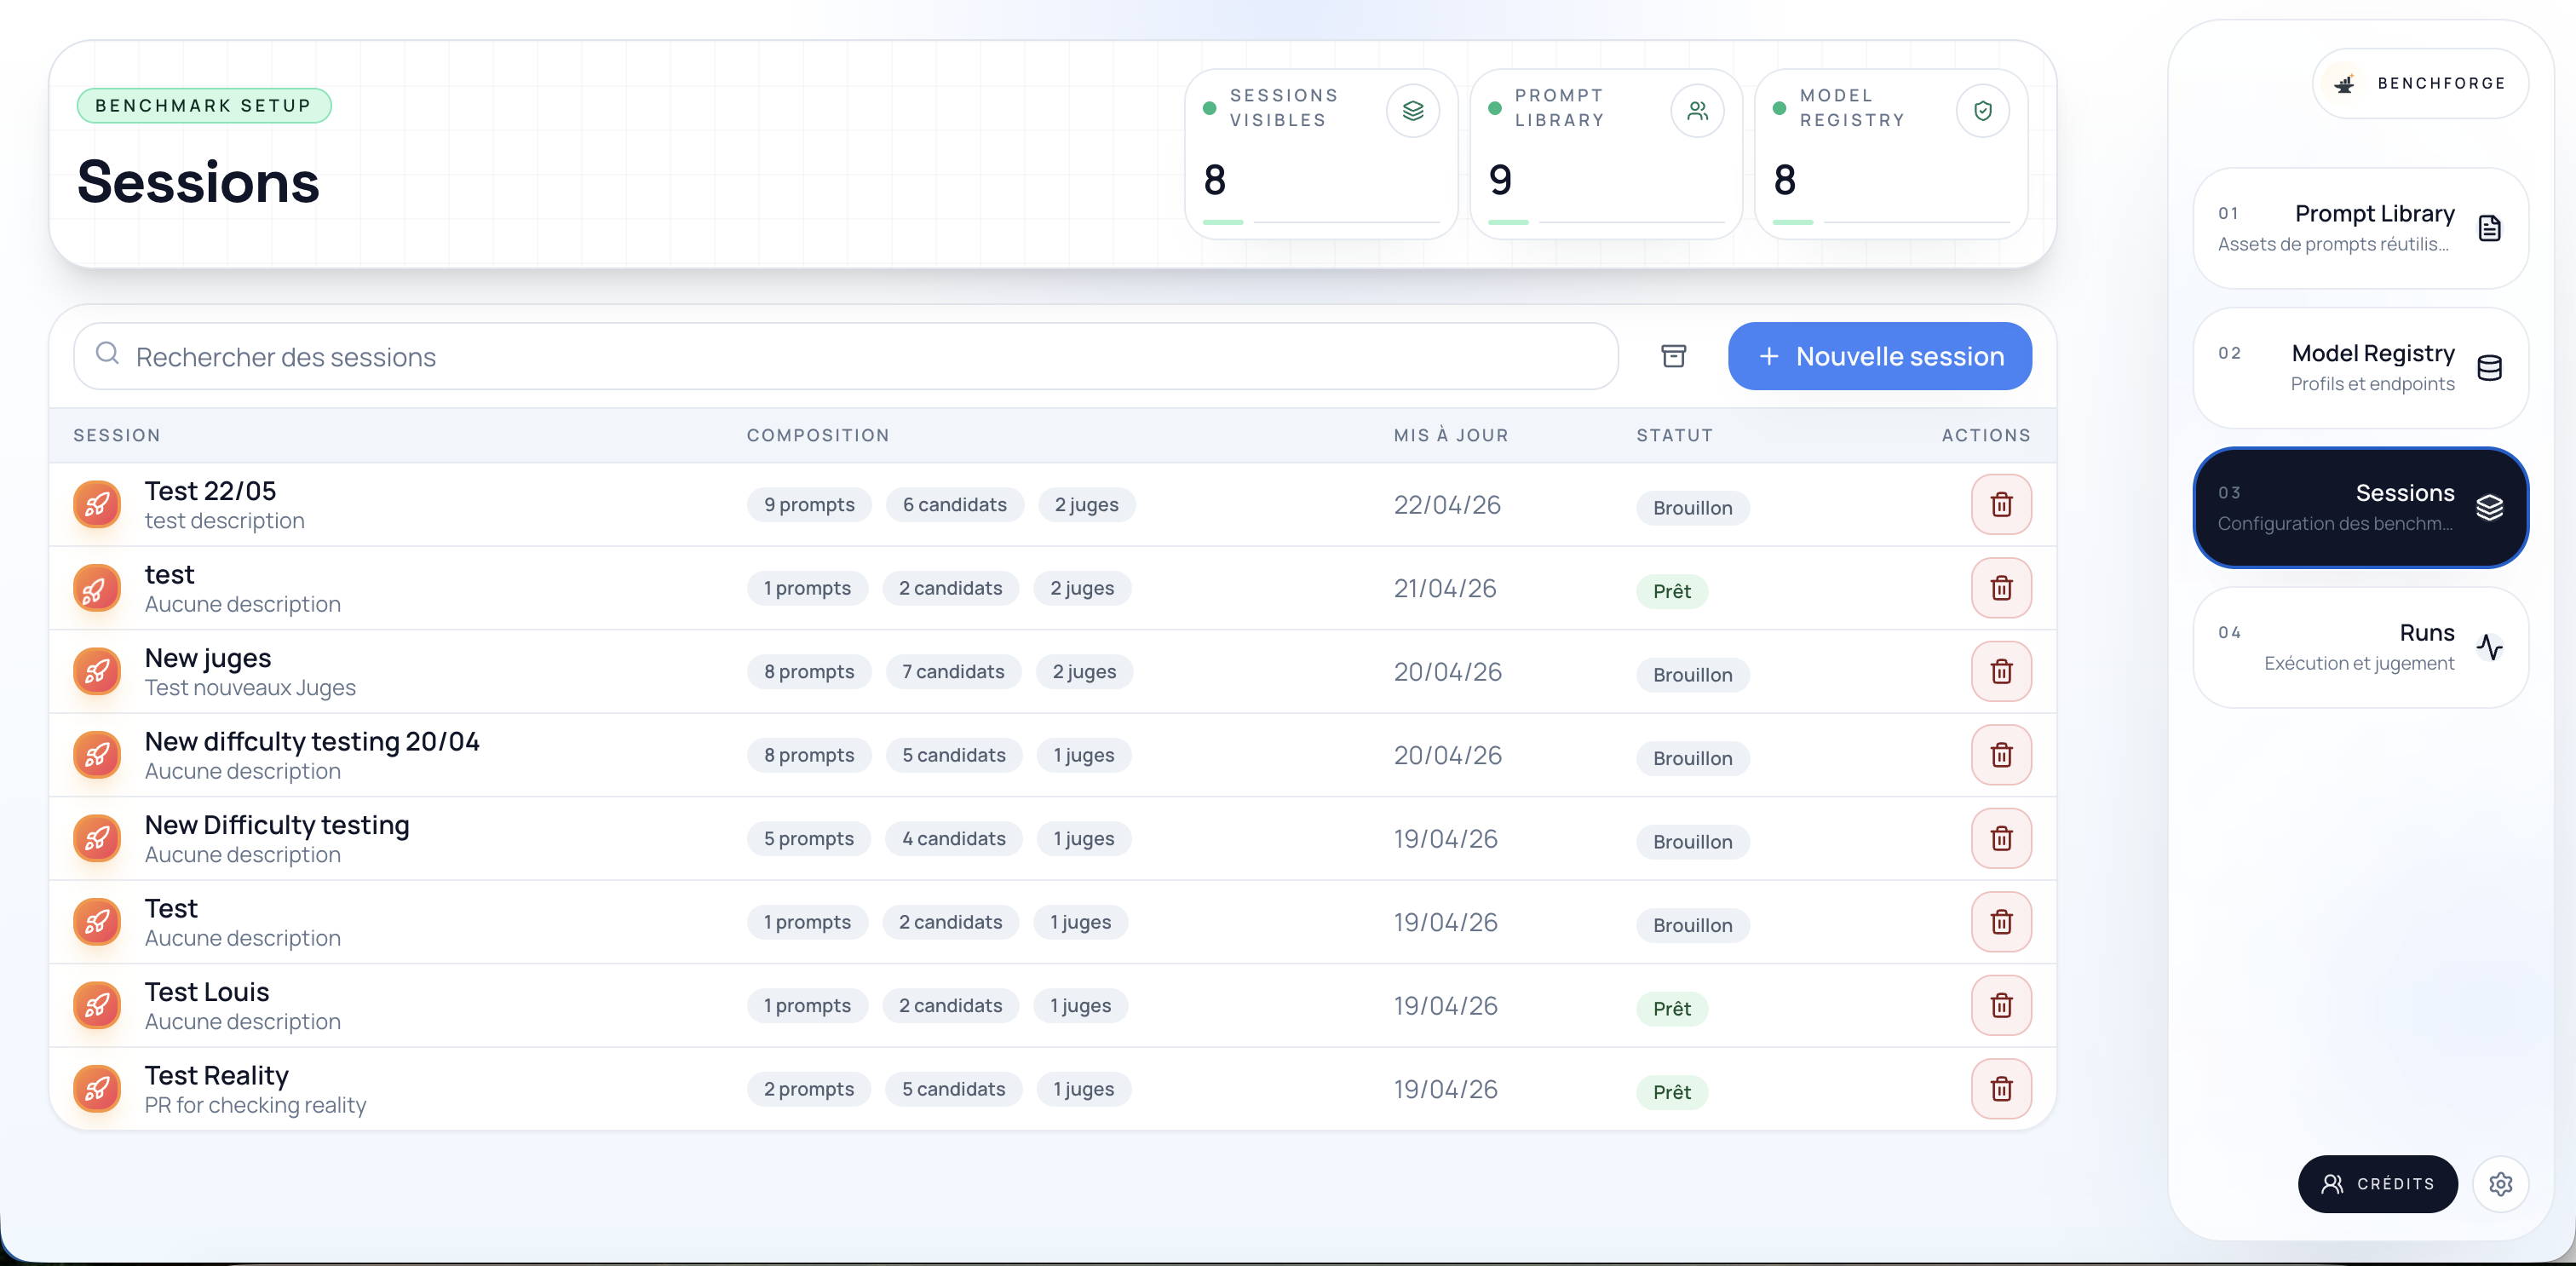
Les sessions permettent de sélectionner une combinaison de prompts, de modèles candidats et de juges. Elles donnent une structure claire au benchmark et facilitent la comparaison dans le temps.
Une session BenchForge correspond à un protocole de test. Elle définit les prompts à exécuter, les modèles candidats, les modèles juges et les règles de comparaison.
L’intérêt est double. D’abord, l’équipe sait précisément ce qui a été testé. Ensuite, elle peut relancer une session plus tard pour vérifier si un nouveau modèle, une nouvelle version ou une nouvelle configuration améliore réellement les résultats.
Cette logique est essentielle pour industrialiser l’IA. Les modèles changent. Les prompts évoluent. Les coûts bougent. Sans historique de benchmark, les décisions deviennent vite subjectives.
À retenir
Un benchmark utile n’est pas un test ponctuel. C’est une base de comparaison que l’on peut rejouer quand les modèles, les prompts ou les contraintes changent.
Phase d’exécution : observer les réponses, pas seulement les scores
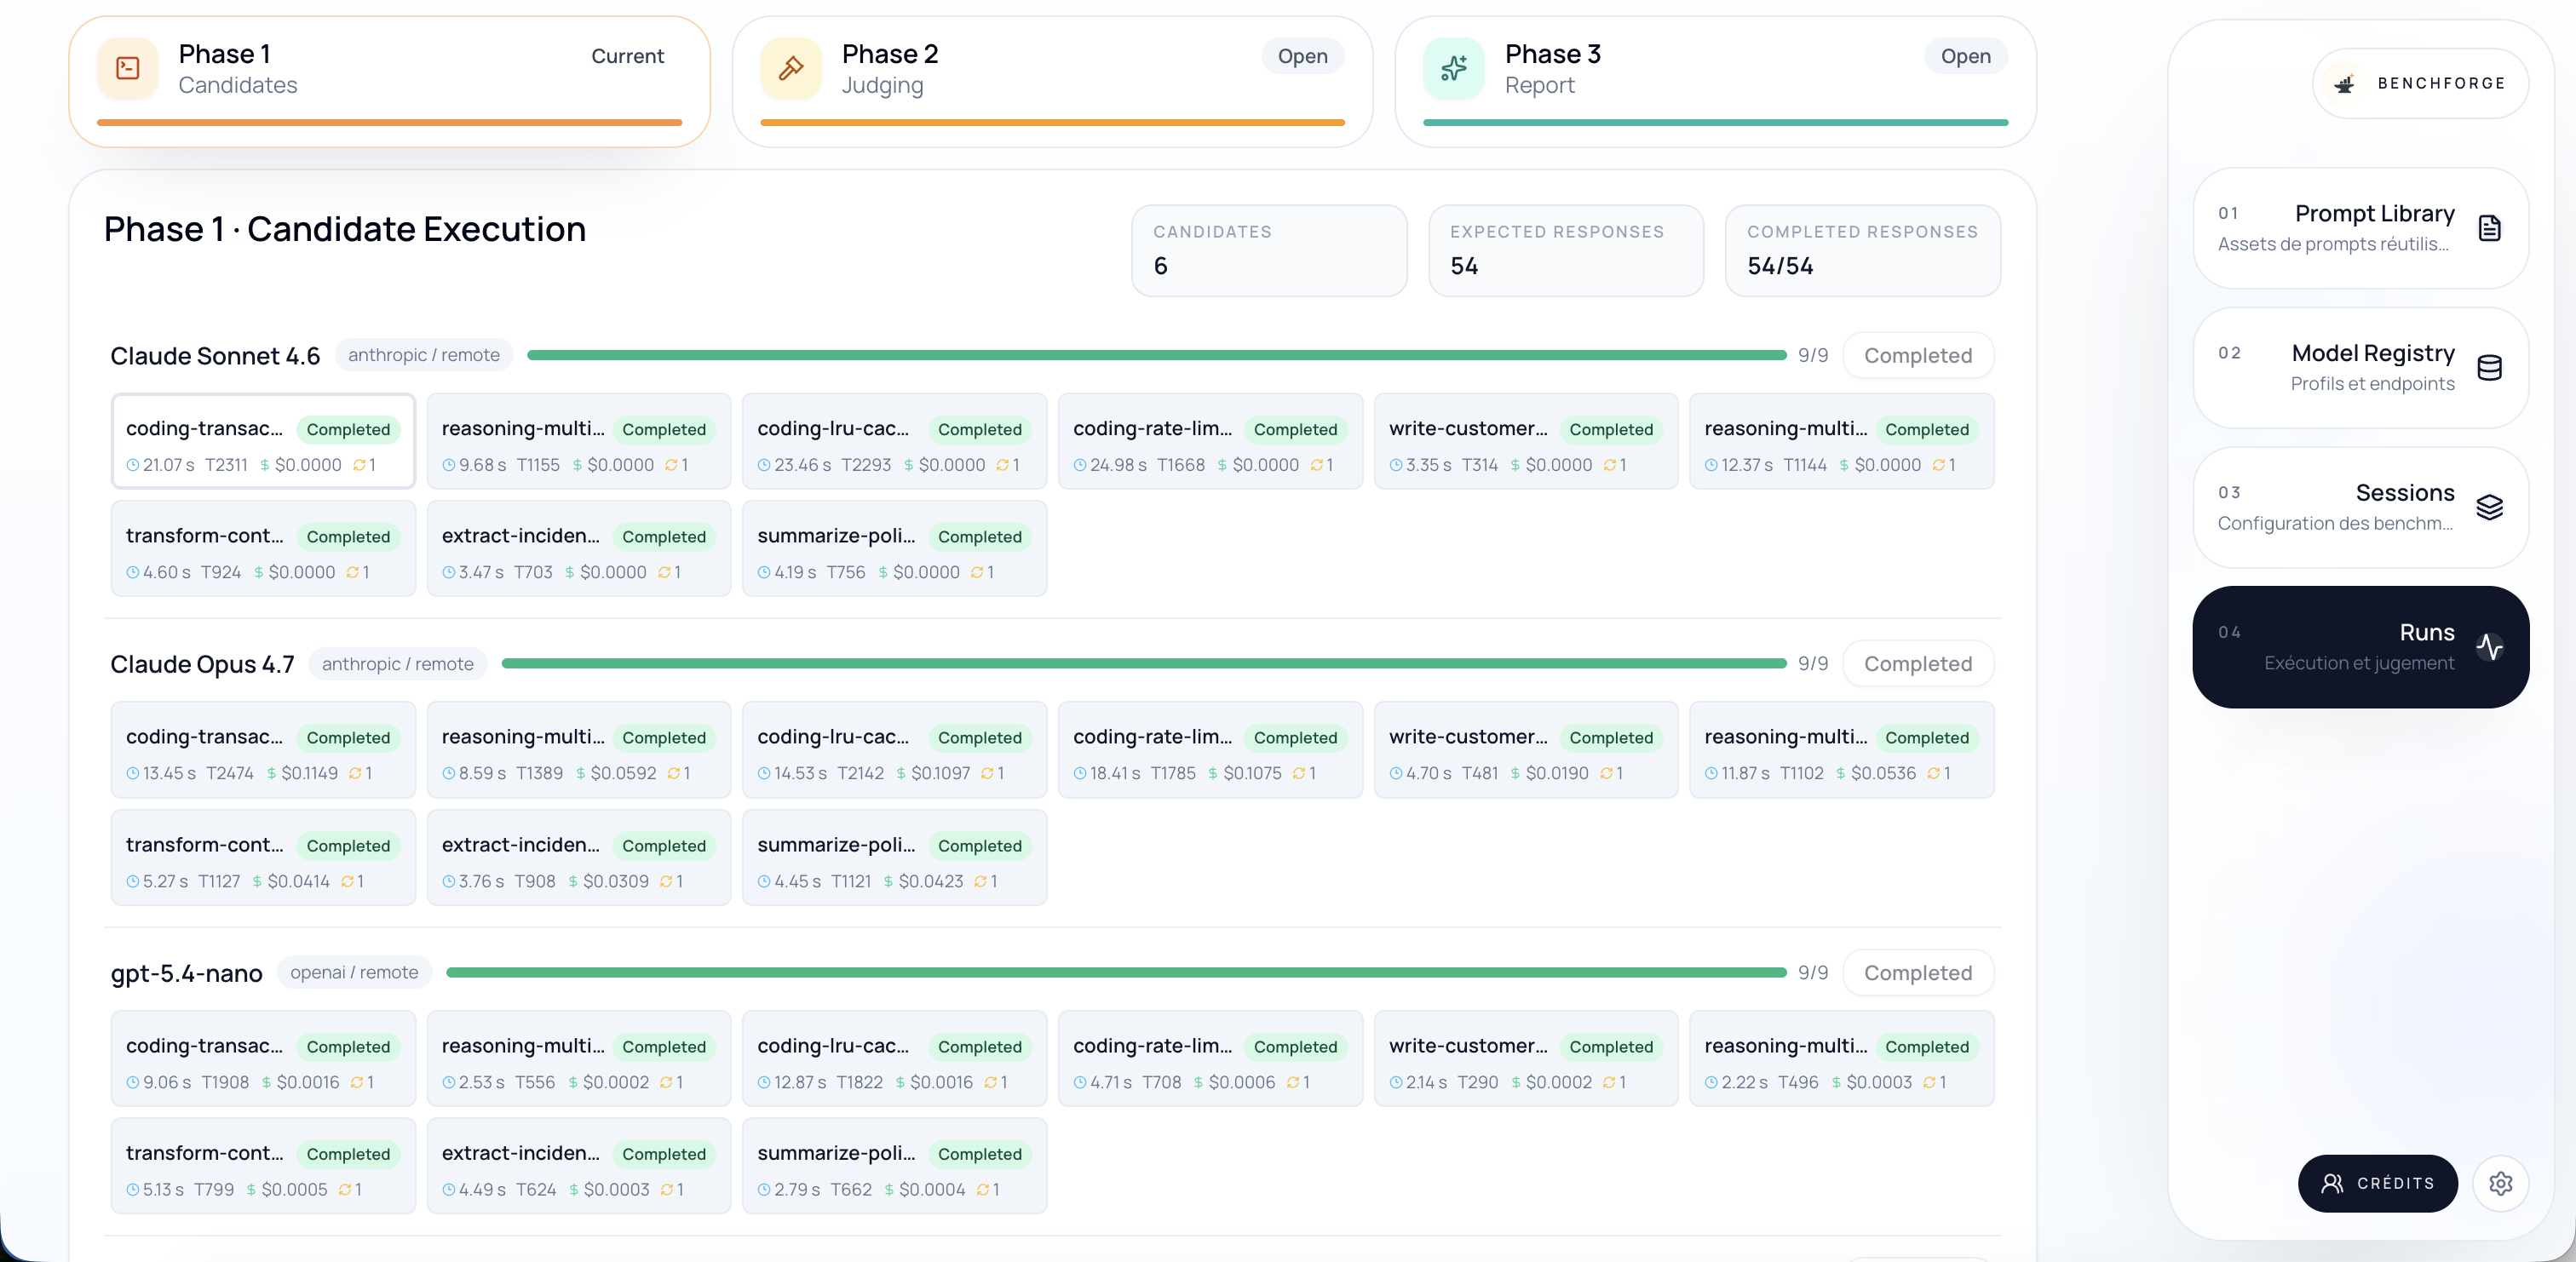
La phase d’exécution permet de suivre les candidats, les réponses attendues, les réponses complétées et l’avancement global de la session.
Le score final est utile, mais il ne raconte pas toute l’histoire. Deux modèles peuvent obtenir une note proche tout en ayant des comportements très différents.
L’un peut produire des réponses courtes, rapides et stables. Un autre peut mieux raisonner, mais au prix d’une latence plus élevée. Un troisième peut être pertinent sur les tâches simples, mais échouer dès que le prompt demande une structuration plus stricte.
C’est pour cette raison que BenchForge ne se limite pas à un tableau final. L’outil permet de suivre les exécutions, d’observer les réponses et de comprendre pourquoi un modèle passe ou échoue sur certains cas.
Le but n’est pas de faire gagner un modèle. Le but est de comprendre ce que chaque modèle fait bien, moins bien, et dans quelles conditions.
Rapports : rendre les compromis visibles
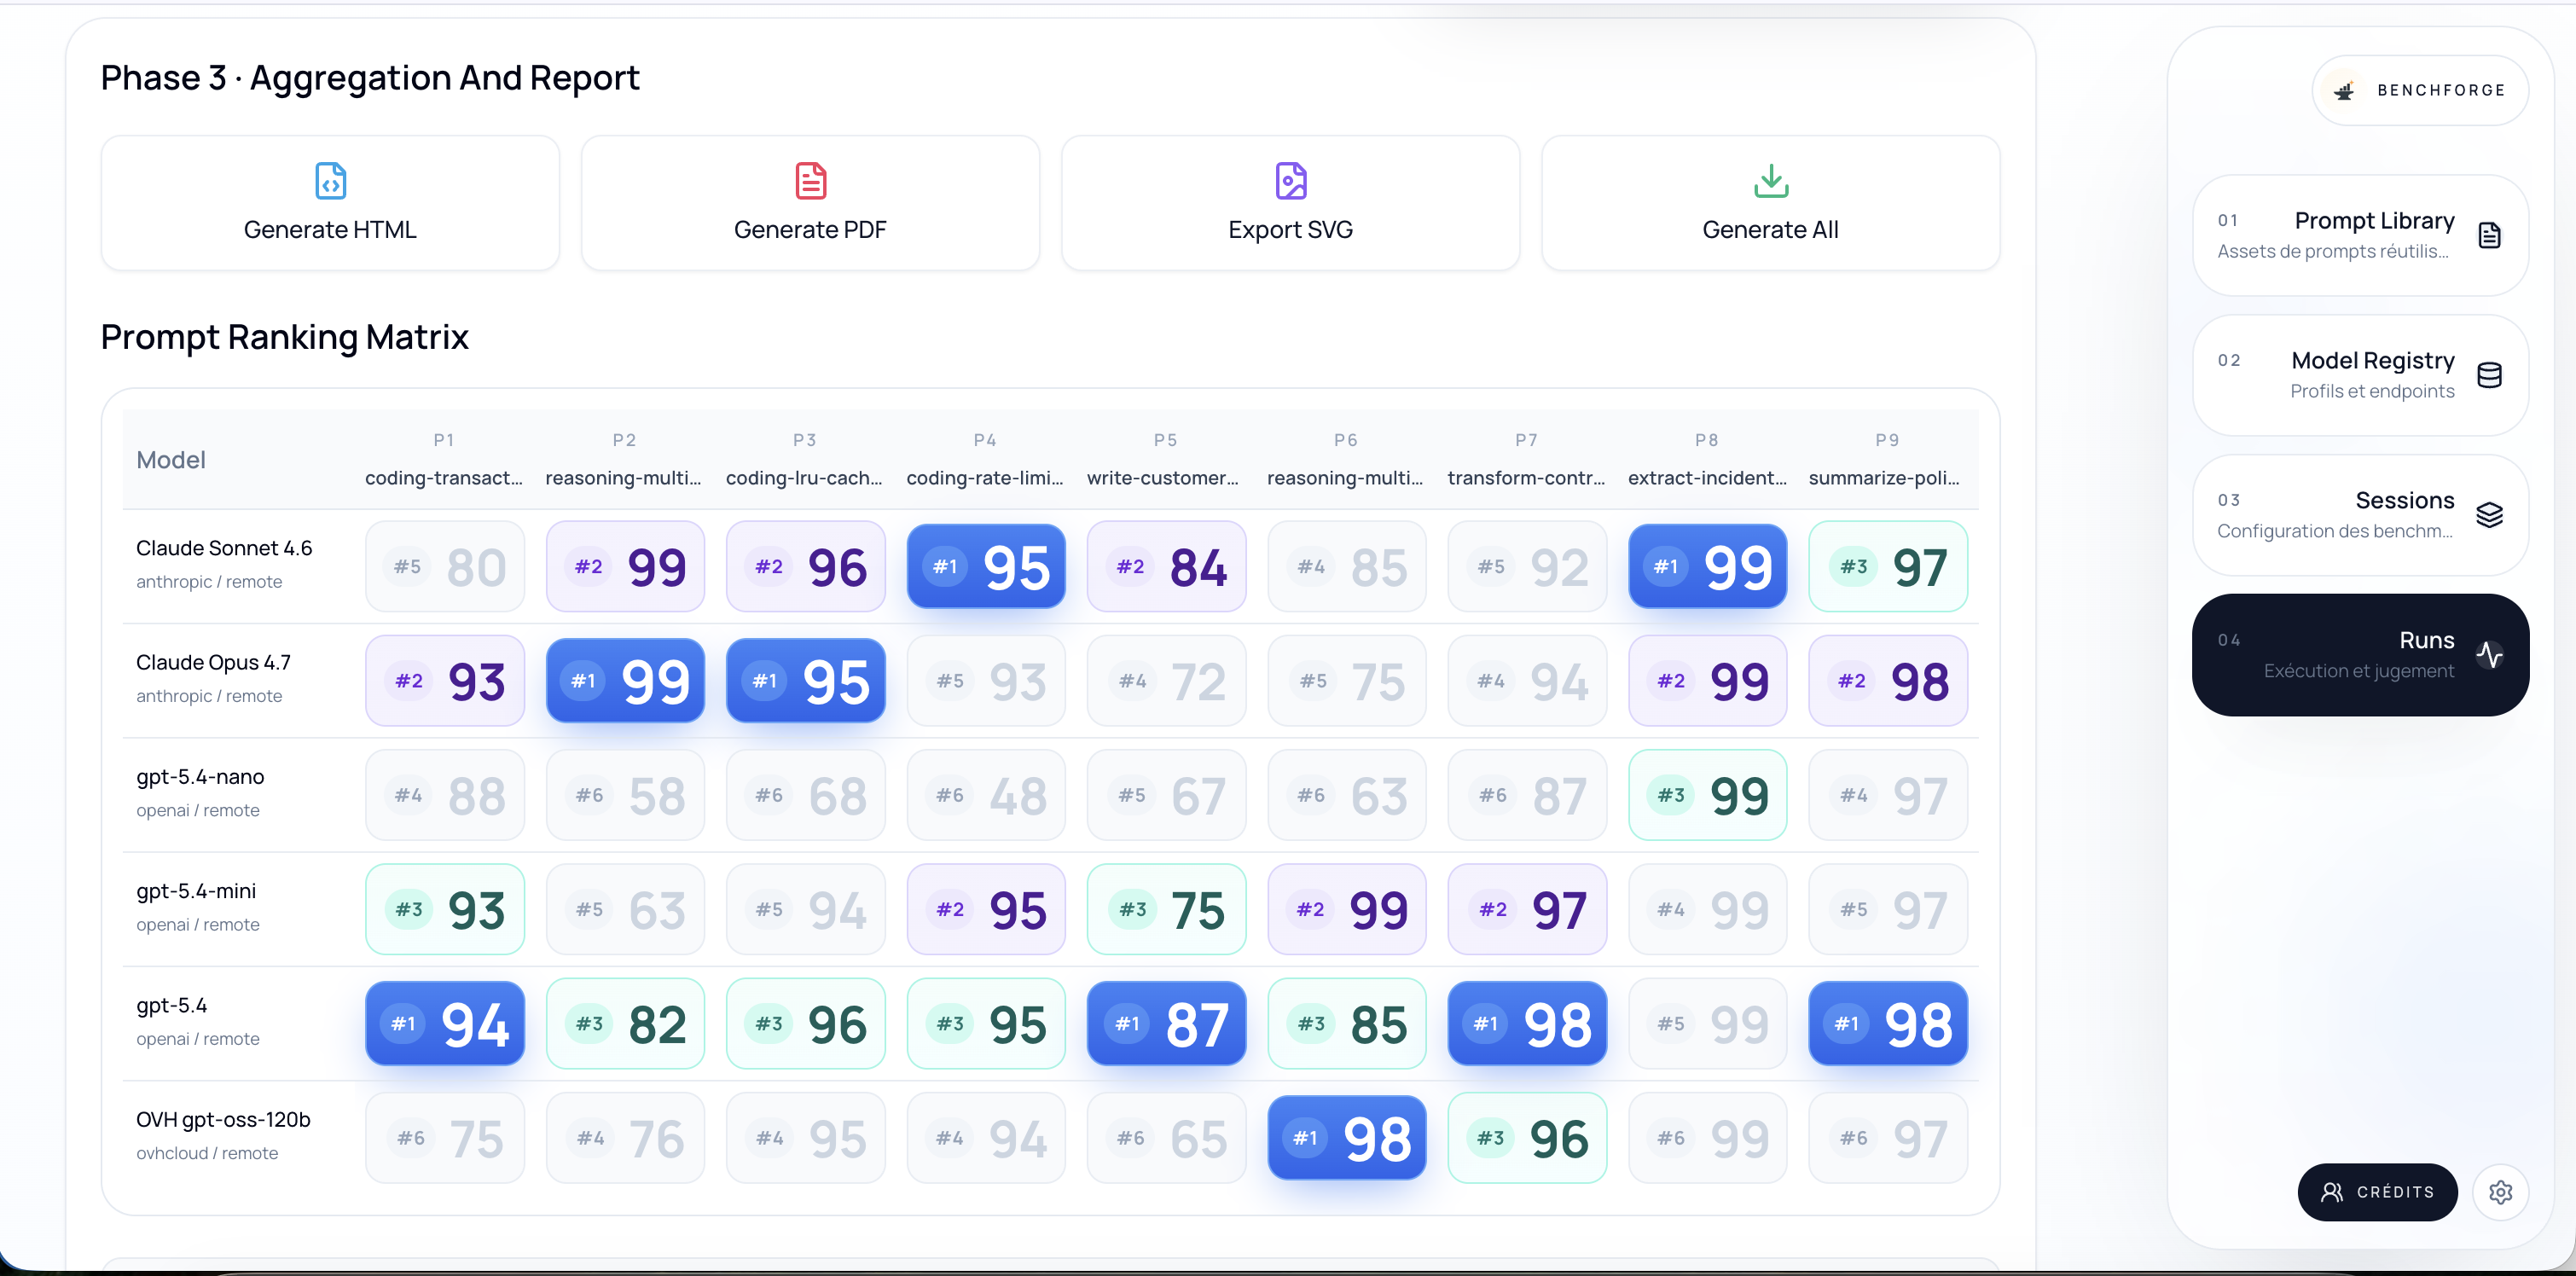
Les rapports permettent de visualiser les résultats sous forme de matrice de ranking, avec une lecture par modèle, par prompt et par critère d’évaluation.
Un benchmark n’a de valeur que s’il peut être compris par les personnes qui doivent décider.
Les équipes techniques ont besoin de détails. Les responsables produit ont besoin de comparer les impacts. Les directions ont besoin de comprendre les coûts, les risques et les gains potentiels.
BenchForge permet de générer des rapports exploitables, exportables en HTML, PDF ou SVG. Cela évite de réduire le choix d’un modèle à une préférence personnelle ou à une tendance du moment.
Propriétaire, open source, local
Comparaison multi-modèles
HTML, PDF, SVG
Exports disponibles
Décider avec des faits
Objectif
Le rapport ne remplace pas l’analyse métier. Il donne une base de discussion plus saine. On peut parler coût, latence, qualité, robustesse et pertinence avec des éléments concrets.
Coût, latence, qualité : le triangle à arbitrer
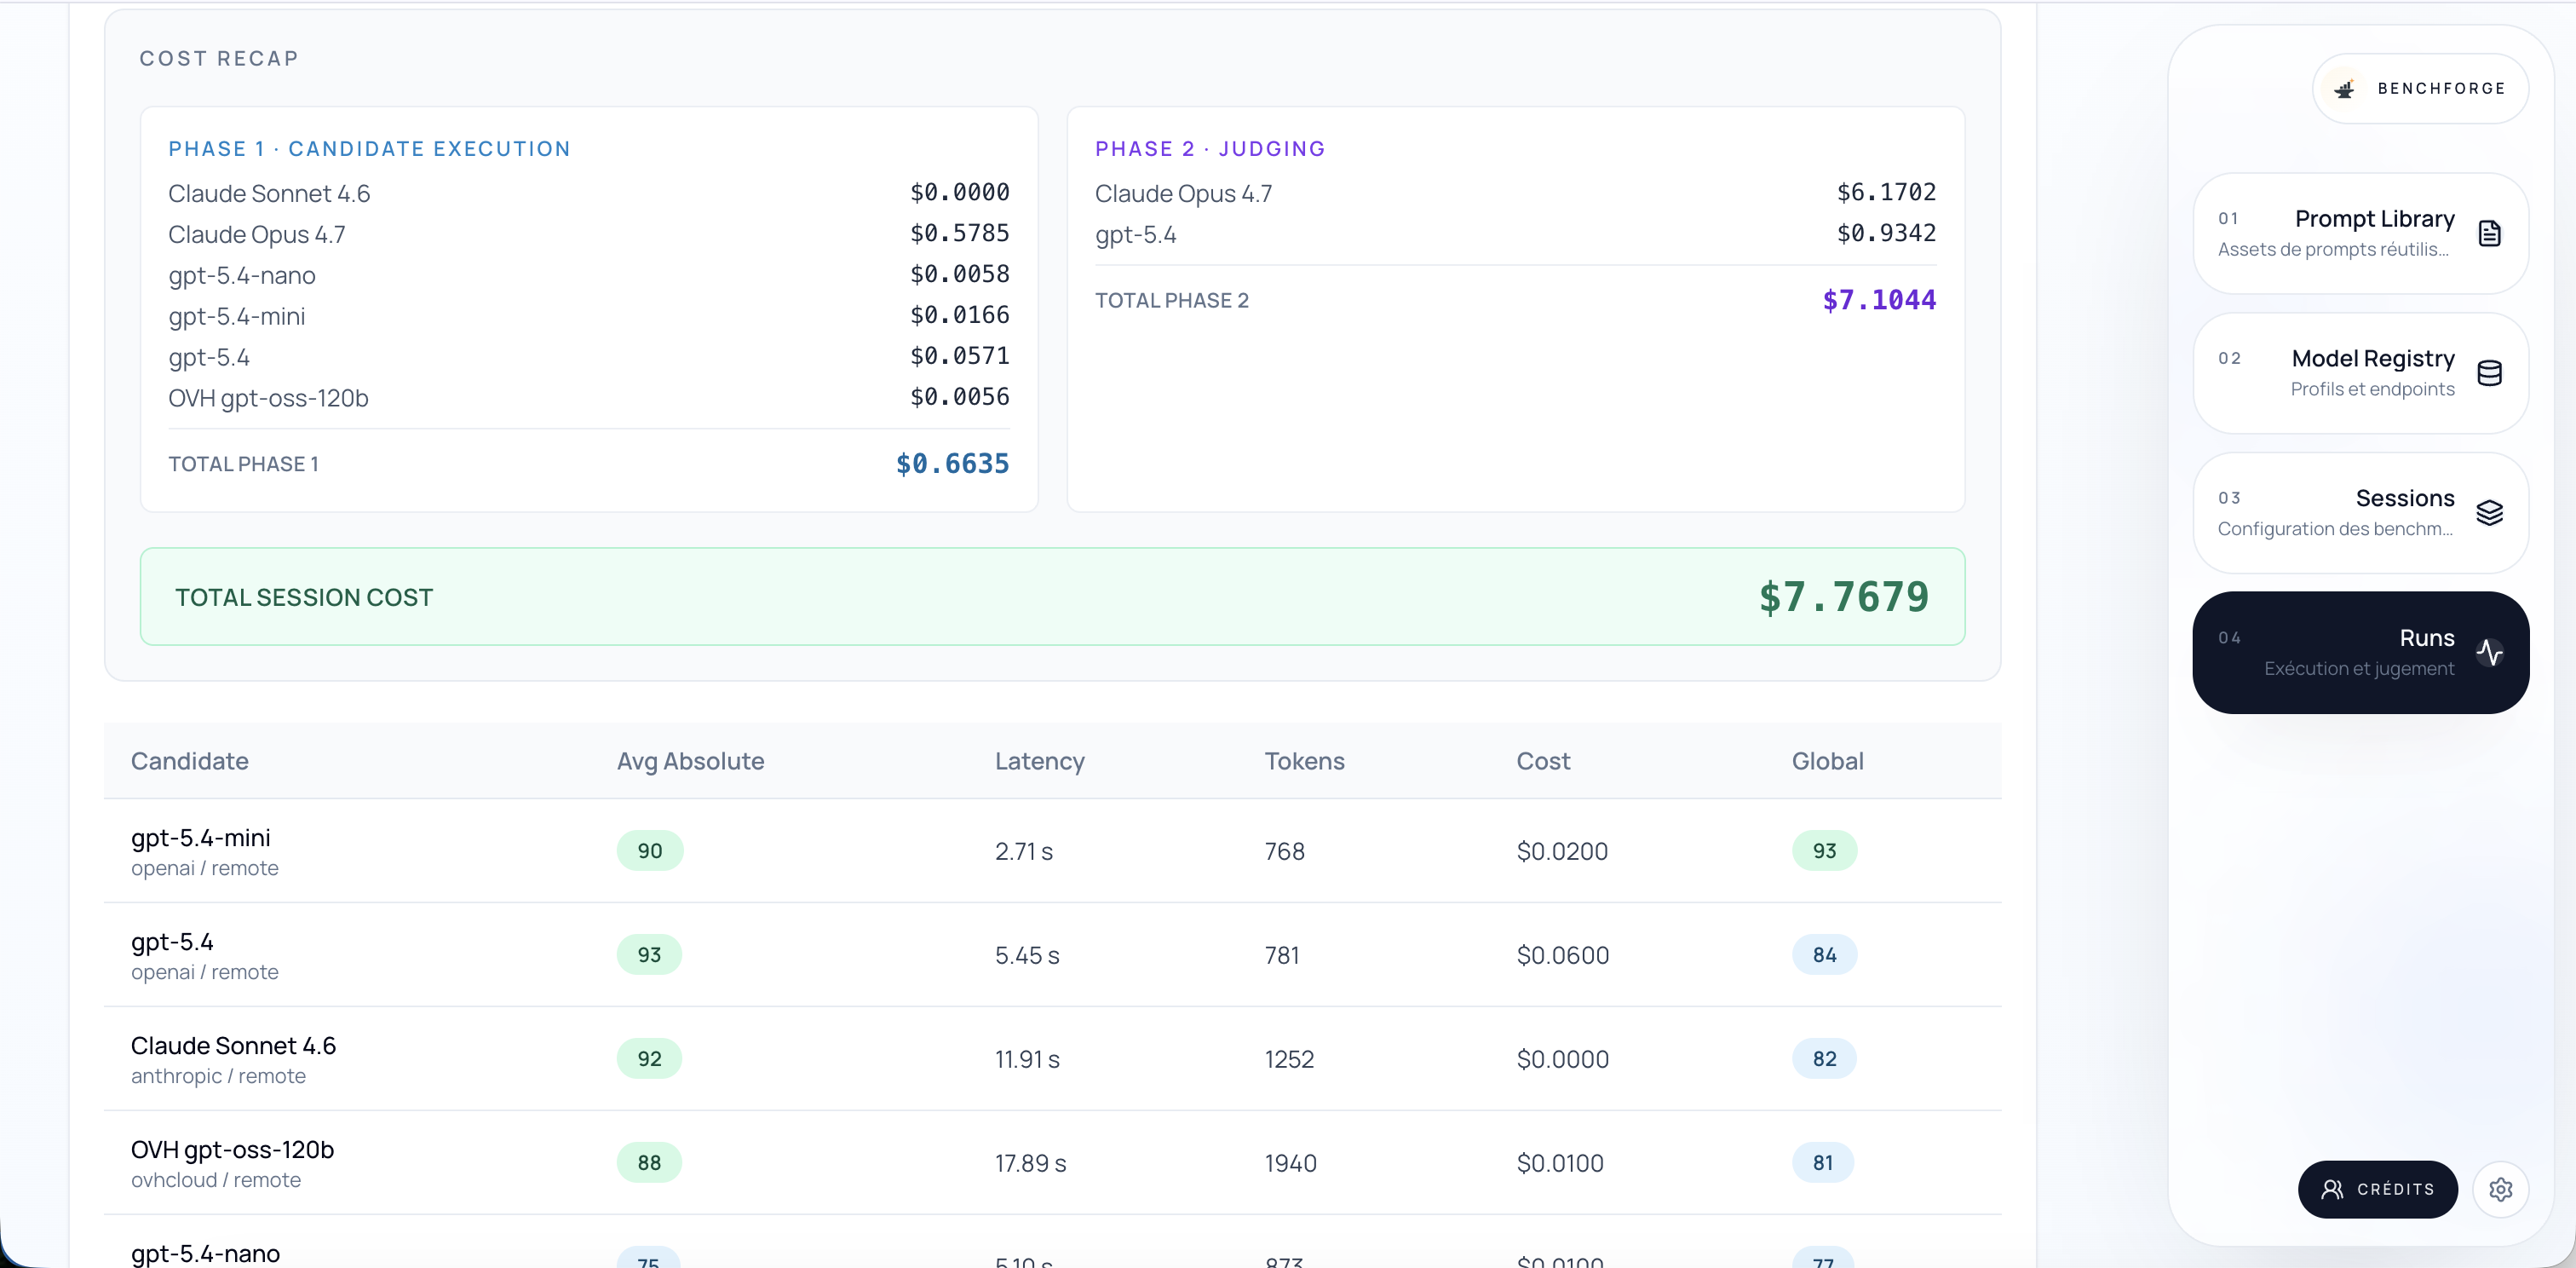
Les vues de coût et de performance aident à comprendre l’impact concret d’un choix de modèle : coût total de session, latence, tokens consommés et score global.
Dans la pratique, le choix d’un modèle repose rarement sur un seul critère.
Un modèle très performant peut être trop coûteux pour des tâches répétitives. Un modèle local peut être intéressant économiquement, mais nécessiter plus de travail d’infrastructure. Un modèle plus léger peut être parfait pour certaines tâches, mais insuffisant sur des cas complexes.
BenchForge aide à rendre ces arbitrages visibles. Il permet de comparer le coût d’une session, la latence moyenne, le volume de tokens et la qualité des réponses.
Bonne pratique
Ne cherchez pas un modèle unique pour tous les usages. Cartographiez vos tâches IA, puis associez à chaque famille de tâches le niveau de modèle réellement nécessaire.
Cette logique est particulièrement importante dans les produits IA en production. À grande échelle, une différence faible sur le coût unitaire peut devenir très significative.
Un cas concret : faut-il vraiment un gros modèle pour chaque tâche ?
Prenons une équipe qui utilise un modèle très performant pour traiter toutes ses requêtes IA : extraction d’informations, résumé, qualification de documents, génération de réponses internes et aide à la décision.
À première vue, ce choix semble rationnel. Le modèle est fiable, connu, facile à intégrer. Mais après quelques semaines, les coûts augmentent, la latence devient visible et certaines tâches répétitives ne justifient pas réellement ce niveau de puissance.
Avec BenchForge, l’équipe peut créer une session de test avec ses prompts réels, puis comparer plusieurs options : un modèle propriétaire puissant, un modèle plus léger, un modèle open source hébergé, et éventuellement un modèle local.
Le résultat peut être très différent selon les prompts. Certaines tâches resteront sur un modèle très performant. D’autres pourront être transférées vers un modèle plus économique. Certaines pourront même être exécutées localement si la confidentialité ou le coût deviennent prioritaires.
On ne remplace pas un modèle par principe. On choisit le bon niveau de puissance au bon endroit.
Ce que l’open source change dans la démarche
L’intérêt d’un outil open source n’est pas seulement économique. Il est aussi méthodologique.
Le benchmark devient inspectable. Les critères peuvent être adaptés. Les prompts peuvent être enrichis. Les modèles peuvent être ajoutés. Les rapports peuvent évoluer selon les besoins d’une équipe, d’un produit ou d’une organisation.
Pourquoi c’est important
Dans un domaine où les offres évoluent très vite, garder la main sur son cadre d’évaluation devient aussi important que le choix du modèle lui-même.
Chez Kintsugy, cette logique nous parle particulièrement. Les sujets IA ne doivent pas être traités uniquement comme des démonstrations techniques. Ils doivent être reliés à des décisions produit, métier et économiques.
BenchForge s’inscrit dans cette approche : expérimenter vite, mais mesurer proprement.
Une démarche utile pour les équipes IA, produit et data
BenchForge peut être utilisé dans plusieurs contextes :
- sélectionner un modèle pour un nouveau cas d’usage ;
- comparer un modèle propriétaire avec une alternative open source ;
- mesurer l’impact d’un changement de prompt ;
- suivre la qualité d’un modèle dans le temps ;
- documenter un arbitrage technique ou budgétaire ;
- tester différentes stratégies d’hébergement.
L’intérêt est particulièrement fort pour les équipes qui industrialisent des usages IA. À partir du moment où les prompts entrent en production, il devient nécessaire de les tester comme on teste du code.
Bonne pratique
Versionnez vos prompts, conservez vos résultats de benchmark et rejouez régulièrement vos sessions lorsque vous changez de modèle ou de configuration.
Ce que nous voulons construire avec BenchForge
BenchForge n’a pas vocation à devenir un énième tableau de classement. L’objectif est plus pragmatique : fournir un outil simple pour aider les équipes à prendre de meilleures décisions.
Nous voulons permettre à chacun de tester ses propres prompts, ses propres modèles et ses propres contraintes.
Pas de vérité toute faite. Pas de réponse unique. Pas de promesse magique.
Seulement une méthode plus claire pour répondre à une question devenue centrale :
Quel modèle IA utiliser, pour quel usage, avec quel niveau de confiance et à quel coût ?
Conclusion : mesurer avant de choisir
Le marché des modèles IA va continuer à se fragmenter. Les grands modèles propriétaires resteront essentiels sur certains usages. Les modèles open source vont continuer à progresser. Les déploiements locaux deviendront de plus en plus crédibles.
Dans ce contexte, la valeur ne sera pas seulement dans le choix d’un modèle, mais dans la capacité à comparer rapidement, proprement et régulièrement.
BenchForge apporte une réponse concrète à ce besoin. Un outil open source, personnalisable, orienté usage réel, qui aide les équipes à transformer leurs intuitions en décisions mesurées.
Découvrir BenchForge
Testez vos prompts, comparez vos modèles et construisez vos propres benchmarks. Les contributions sont ouvertes et les retours terrain sont les bienvenus.
Ce sujet vous parle ?
Discutons de votre contexte et de la facon dont l'IA peut repondre a vos enjeux.